Почему страница не в индексе: разбор статусов Search Console
Что означают статусы отчёта об индексировании страниц в Search Console, какие из них ошибки, а какие нет, в каком порядке разбирать причину и как подтвердить исправление.
Отчёт об индексировании страниц в Search Console объясняет, почему страница не в индексе Google. Но не каждый статус — ошибка: часть означает, что Google сделал ровно то, что вы просили, или выбрал другую версию страницы. Поэтому разбор начинают с вопроса «должна ли эта страница вообще быть в поиске», а уже потом смотрят статус.
Ниже — как проверить одну страницу, таблица статусов «что значит — что делать», три группы причин и как подтвердить исправление.
Сначала: проверить одну страницу
Откройте адрес в инструменте проверки URL. Он показывает, есть ли страница в индексе, какую каноническую версию выбрал Google и разрешены ли обход и индексация. Живая проверка запрашивает страницу прямо сейчас — так удобно убедиться, что исправление работает.
Одна важная деталь из справки: если страница закрыта в robots.txt, поле «Индексирование разрешено?» всегда показывает «Да», потому что Google не видит директиву noindex на закрытой странице.
Статусы и что с ними делать
Формулировки статусов — по справке Search Console:
| Статус | Что значит | Что делать |
|---|---|---|
| Server error (5xx) | Сервер ответил ошибкой | Проверить нагрузку, логи и доступность в момент обхода |
| Redirect error | Цикл, слишком длинная цепочка или неверный адрес редиректа | Перенаправлять сразу на итоговый адрес |
| Blocked by robots.txt | Обход запрещён в robots.txt | Если страница нужна в поиске — открыть её в robots.txt |
| Excluded by 'noindex' tag | На странице директива noindex | Если страница нужна в поиске — убрать noindex |
| Not found (404) | Страница не найдена | Если страница переехала — постоянный редирект на новый адрес |
| Soft 404 | Страница выглядит как «не найдено», но отвечает кодом успеха | Отдавать 404 или наполнить страницу содержанием |
| Page with redirect | Адрес перенаправляет на другой | Обычно ничего: в индекс попадёт целевая страница |
| Alternate page with proper canonical tag | Альтернативная версия с правильным canonical | Ничего, это нормально |
| Duplicate without user-selected canonical | Дубль без указанного canonical, Google выбрал сам | Не ошибка; при необходимости указать canonical |
| Duplicate, Google chose different canonical than user | Google считает канонической другую страницу | Проверить, действительно ли страницы разные; согласовать сигналы |
| Crawled — currently not indexed | Страница просканирована, но не проиндексирована | Повторная отправка не нужна; улучшать содержание и внутренние ссылки |
| Discovered — currently not indexed | Адрес известен, но ещё не просканирован | Проверить нагрузку на сервер, внутренние ссылки, sitemap |
Три группы причин
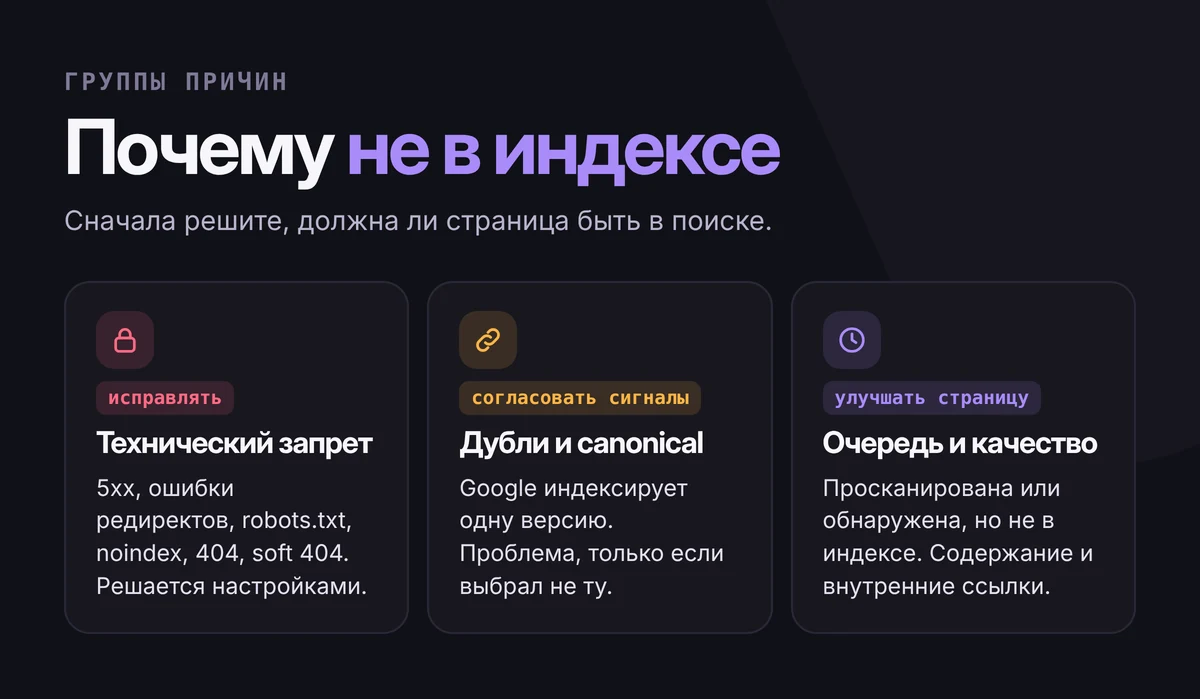
Технический запрет. Ошибки сервера и редиректов, robots.txt, noindex, 404 и soft 404. Здесь всё решается настройками: страница либо недоступна, либо вы сами запретили её индексировать. Частая история — запрет индексации, оставшийся с тестового сервера после запуска.
Дубли и канонические версии. Google видит несколько похожих адресов и индексирует один. Это нормально для страниц с параметрами, вариантов товара или версий для печати. Проблема только тогда, когда Google выбрал не ту страницу, которую вы хотели видеть в поиске. Сигналы должны совпадать: canonical, редиректы, внутренние ссылки и sitemap указывают на одну и ту же версию.
Очередь и качество. «Просканирована, но не проиндексирована» и «обнаружена, но не просканирована» — не ошибки настройки. Google сам решает, что индексировать и когда. Для первой группы справка прямо говорит, что повторно отправлять страницу не нужно. Помогает другое: уникальное содержание, которое отвечает на вопрос лучше похожих страниц, и внутренние ссылки с важных страниц сайта. Для второй группы Google может откладывать обход, чтобы не перегружать сервер — стоит проверить скорость ответа.
Порядок разбора
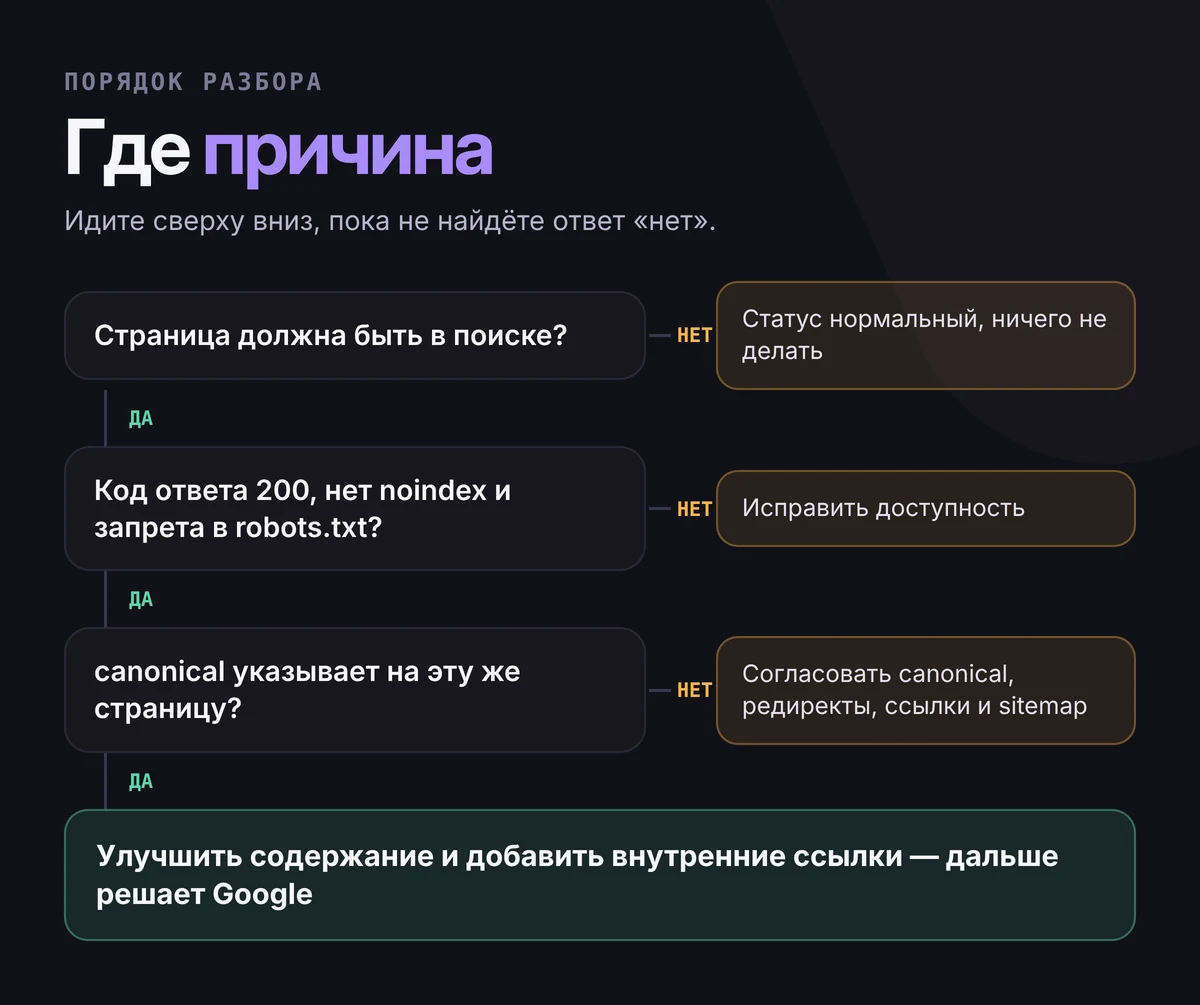
- Решите, должна ли страница быть в поиске. Служебные страницы, фильтры и дубли там не нужны.
- Проверьте доступность: код ответа 200, нет запрета в robots.txt и noindex.
- Проверьте canonical: он указывает на эту же страницу и совпадает с sitemap и внутренними ссылками.
- Проверьте содержание: страница отвечает на вопрос и отличается от соседних.
- Проверьте ссылки: на страницу можно попасть из меню, каталога или других страниц.
Как подтвердить исправление
По справке Search Console:
- Исправьте проблему на всех страницах с этим статусом — проверка останавливается, если осталась хотя бы одна.
- Откройте статус в отчёте и нажмите «Проверить исправление» (Validate fix). Повторно не нажимайте, пока проверка не закончится.
- Ждите: обычно это занимает до двух недель.
- Если проверка не прошла, откройте подробности, найдите адрес, на котором осталась проблема, исправьте и запустите проверку заново.
Чего не делать
- Не отправляйте одну и ту же страницу на индексирование каждый день — это не ускоряет процесс.
- Не закрывайте страницу в robots.txt, если хотите убрать её из индекса: поисковик не увидит noindex.
- Не перенаправляйте все удалённые страницы на главную — это может стать soft 404.
В разработке сайтов PIP техническая подготовка к индексации может входить в объём работ — так сказано на странице разработки сайтов. Страницы выпадают из поиска и непонятно почему? Расскажите о задаче — разберём отчёт по статусам.
Короткие подсказки о сайтах и автоматизации — в Telegram-канале @pip_kz.